主要モデルをすべて、同じ妨害工作入りのアプリでテスト
v4は、7回のスプリントで育っていく1つのRailsアプリです。その間、隔離されたサブエージェントが実在のCVEをもとにした14個の妨害工作を仕込みます。モデルは注意深さで順位付けします。壊れているところに気づいて直したか。ここにたどり着くまでに、ベンチマークを一から作り直すのは3回目でした。
主要なフロンティアモデルが出るたびに、同じ表で走らせます。直近の回では2026年9月23日に5モデルを追加しました。どのモデルを何に使うか、タスクあたりいくらかかるかは、これで決めています。
- 44
- 順位付けしたモデル
- 14
- 見抜くべき妨害工作
- 7
- 1回の実行あたりのスプリント
- $4,000+
- 9日間で使った金額
ベンチマーク
私がモデルを選ぶ根拠のデータと、古いテストが頭打ちになって手法がどう変わったか。
LLMベンチマークv4:Opus 5.5、GPT 6 SolとLuna、MiMo 2.6、Grok 4.7
v4の表に新しく5つのモデルが加わりました。乗り換える価値はあるのか。そしてGrok 4.7が前のバージョンより後退した理由。
新LLMベンチマークv4、パート1:進め方
1バージョンを丸ごと捨てた理由、妨害工作を仕込んだRailsアプリの仕組み、そしてかかった費用。9日間で4,000ドル超です。
新LLMベンチマークv4、パート2:39モデルのランキング
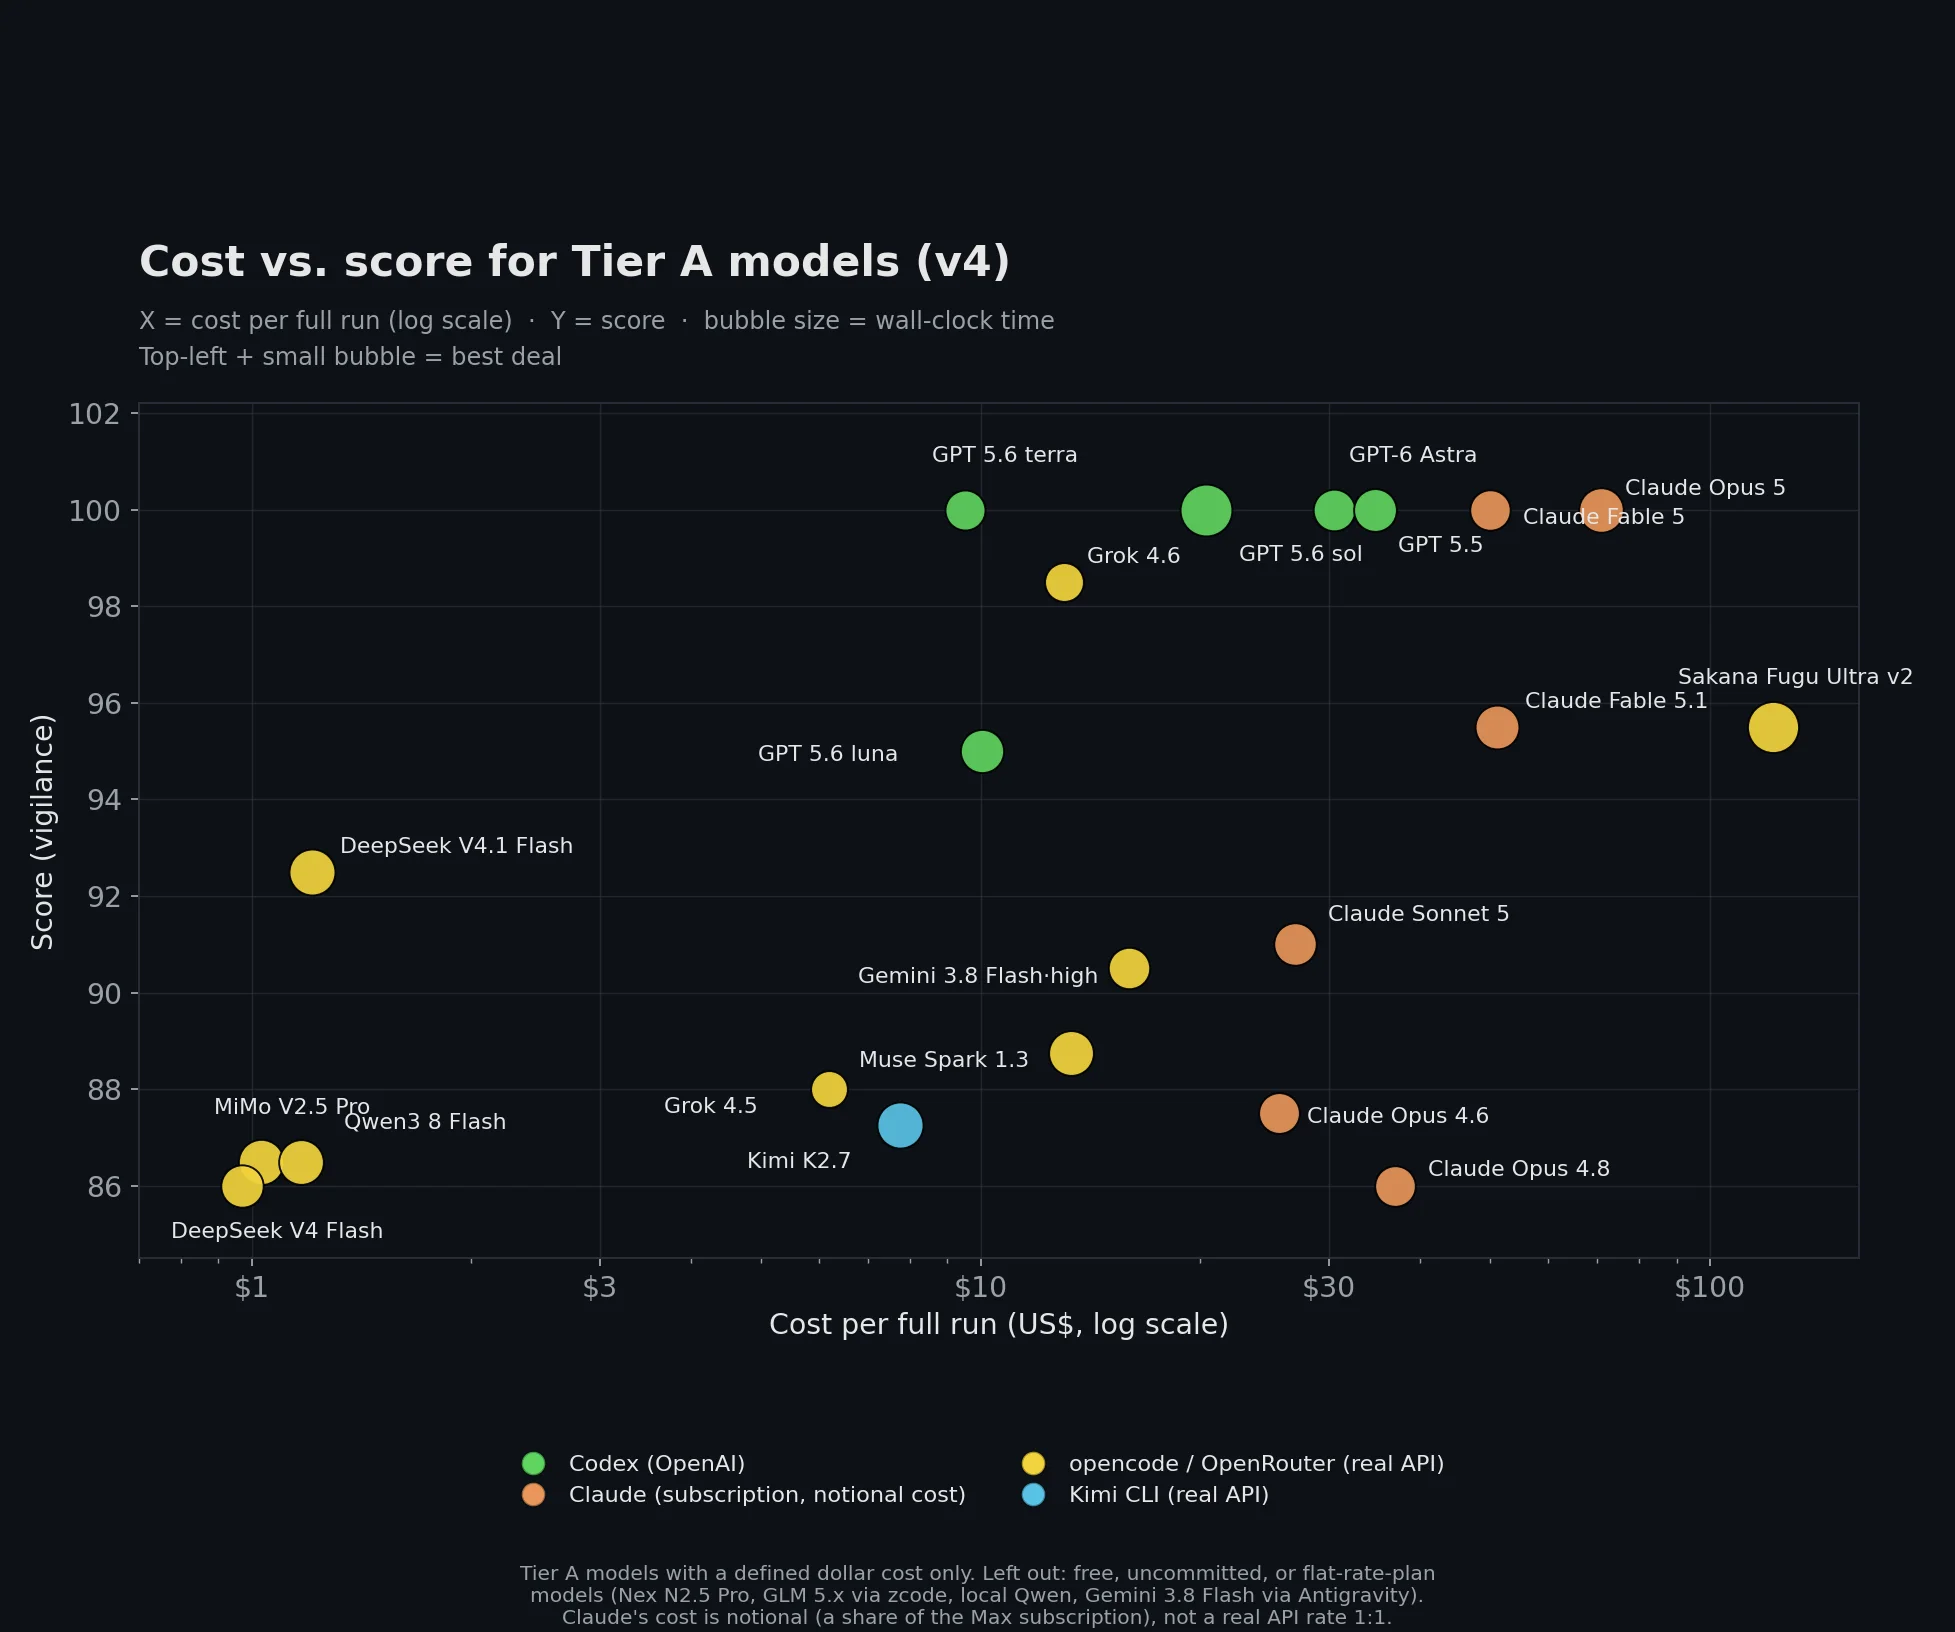
注意深さで並べた全ランキング。首位は6モデルが同点、無料モデルがClaudeの半分に勝ち、コストとスコアの関係も載せています。
LLMベンチマーク:1つのプロジェクトで複数モデルを混ぜる価値はあるか
Claude Code、opencode、Codexで7通りの組み合わせを試しました。それでも強いモデル1つがデフォルトのままだった理由。
エージェントとの働き方
1人でこれだけのプロジェクトをメンテナンスするためのプロセス、スキル、安全網。
私のAIスキルについて少し話します
スキルはテキストファイルに書いたプロンプトです。私のスキルは1,000件を超えるプルリクエストとIssueをクローズしました。読んでから、自分のものを書いてください。
言い訳はやめて、もっとリリースしよう
フロンティアモデルは大半の開発者よりミスが少ない。そうなるとレビューの手続きがデプロイを止める最後の言い訳です。2月以降の私の数字を公開します。
オープンソースへのAIによる貢献:私の考え
AIが書いたプルリクエストは、質の低いものも含めてなくなりません。トリアージと監査は自動化し、最終判断は人間に残しましょう。
LLM時代のオープンソースのベストプラクティス:最低限これだけ
簡単なインストール、信頼できるテストとCI、問題を説明するドキュメント。標準的なリリースなら自動化の挙動も読めます。
AIエージェントのためのClean Code
主な読み手がエージェントになったら。小さなコード、grepしやすい名前、出どころの記録、ヘッドレスなテスト、明示的なルール。
エージェントにファイルを消させないために私がしていること
YOLOモードで5か月、事故はゼロ。それでも信用はしていません。BTRFSスナップショット、resticバックアップ、サンドボックス、そして規律。
実験とツール
作ったものや試したもの。うまくいかなかったものも含めて。
AIへの挑戦:NESのROMをマスターシステムに変換する
フロンティアモデルに6502からZ80への変換をやらせ、エミュレーターを判定役にしました。どこでマッパーが全部を止めてしまうのかも。
日々のちょっとした問題をAIで解決する
ウィジェット付きの卓上時計、マンガリーダー、メール、タイピング練習、カラオケ。小さな不満から生まれた小さなツールです。
ai-memory 2.0
オープンなOKFフォーマット、デフォルトでローカル埋め込み、チームでの並行作業。ほかの選択肢との比較も。
バイブコーディング:ゼロから本番まで6日間
The M.Akita Chroniclesのニュースレター、ブログ、ポッドキャスト、Discordボットを6日間、201コミットで公開した話。
意見
ハイプに反論しているところ。きつい言葉を覚悟してください。