Tudo que eu aprendo sobre IA, por escrito
Eu tenho blog desde 2006. Hoje a maior parte é sobre trabalhar com LLMs: o que funciona, quanto custa e o que é marketing. Todo post sai em português e em inglês.
Todos os grandes modelos, testados no mesmo app sabotado
A versão 4 é um único app Rails que cresce ao longo de sete sprints enquanto um subagente isolado planta catorze sabotagens baseadas em CVEs reais. Os modelos são ranqueados por vigilância: perceberam o que estava quebrado e consertaram? Eu refiz o benchmark do zero pela terceira vez pra chegar nisso.
Quando sai um grande modelo de fronteira, ele passa pela mesma tabela. A última rodada adicionou 5 modelos em 23 de setembro de 2026. É assim que eu escolho qual modelo usar pra quê, e quanto cada um custa por tarefa.
- 44
- modelos ranqueados
- 14
- sabotagens pra pegar
- 7
- sprints por rodada
- $4.000+
- gastos em 9 dias
Benchmarks
Os dados por trás das minhas escolhas de modelo, e como o método mudou quando os testes antigos saturaram.
LLM Benchmark v4: Opus 5.5, GPT Sol/Luna 6, Mimo 2.6, Grok 4.7
Cinco modelos novos entram na tabela v4. Vale a pena trocar? E por que o Grok 4.7 regride em relação ao próprio antecessor.
Novo LLM Benchmark v4: retestando TODOS os principais LLMs (Parte 1)
Por que joguei fora uma versão inteira, como funciona o app Rails sabotado e quanto custou: mais de US$ 4.000 em nove dias.
Novo LLM Benchmark v4: retestando 39 LLMs (Parte 2)
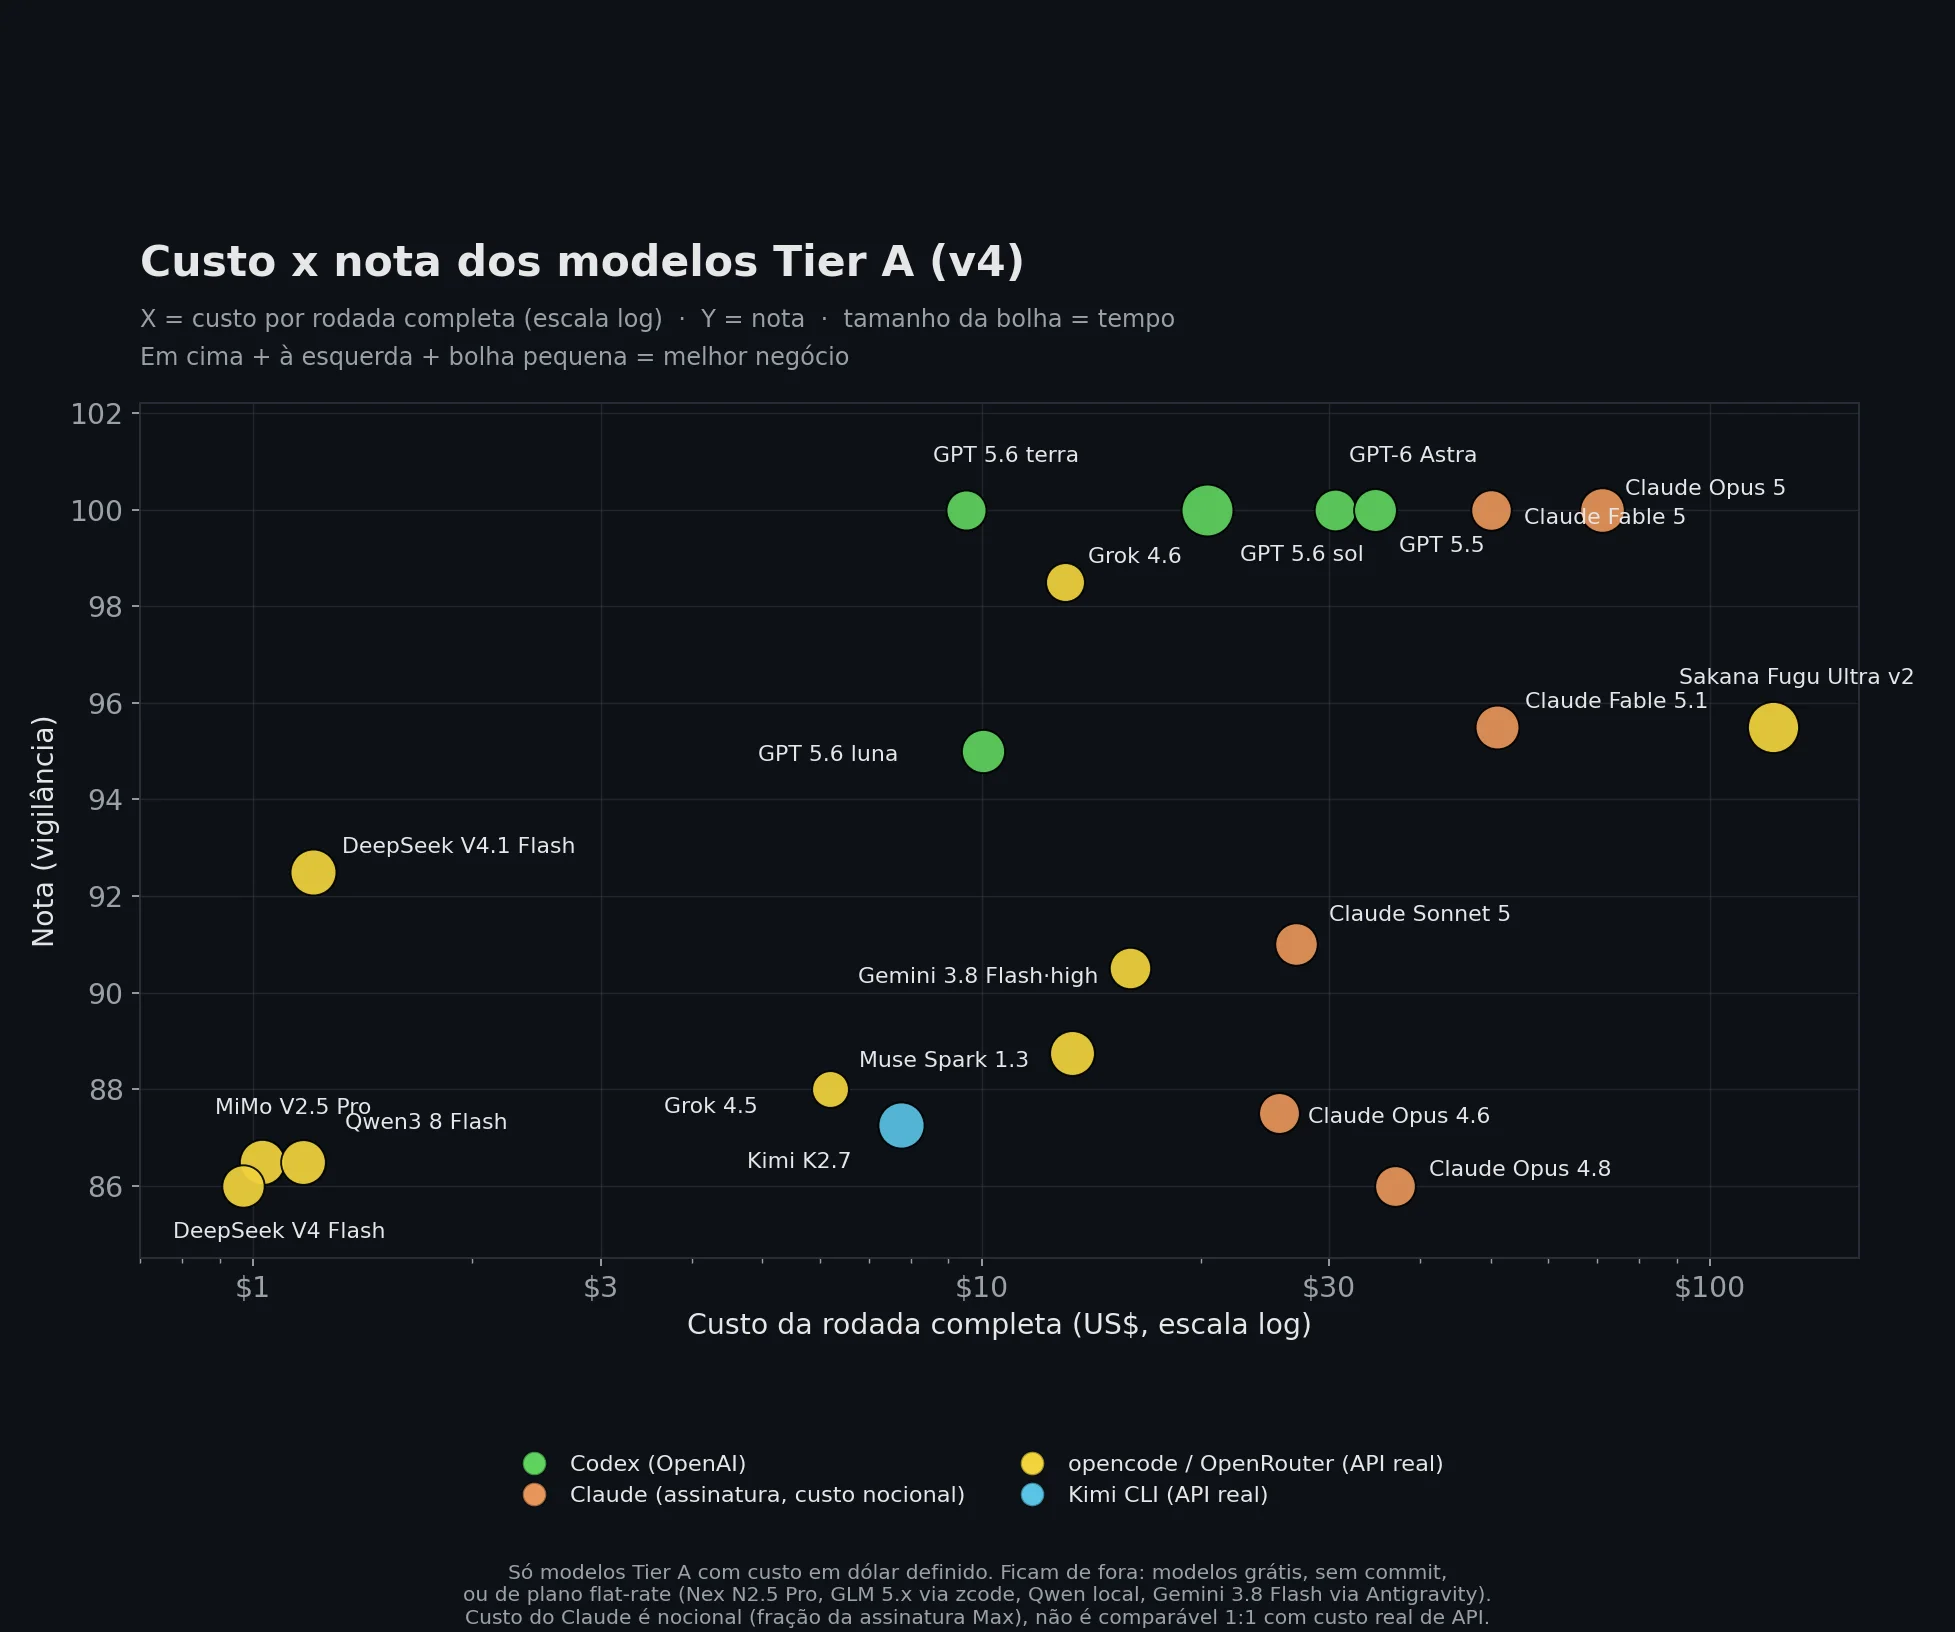
A tabela completa, ordenada por vigilância. Seis empates no topo, um modelo gratuito batendo metade dos Claude e custo contra nota.
LLM Benchmarks Parte 2: Vale Combinar Múltiplos Modelos no Mesmo Projeto? Claude + GLM??
Sete combinações entre Claude Code, opencode e Codex, e por que um único modelo forte continuou sendo o padrão.
Como eu trabalho com agentes
O processo, as skills e as redes de segurança que deixam uma pessoa só manter tantos projetos.
Falando um pouco sobre minhas Skills de IA
Skills são prompts em arquivos de texto. As minhas fecharam mais de mil PRs e issues. Leia as minhas e depois escreva as suas.
Parem de inventar desculpas e façam mais deploy! Com a IA, a premissa mudou. Entendam.
Com modelos de fronteira errando menos que a maioria dos devs, burocracia de review é a última desculpa pra segurar um deploy. Meus números desde fevereiro.
Controvérsia de IA em contribuições de projetos de código aberto - minha opinião
Pull requests feitos com IA vieram pra ficar, slop incluído. Automatize a triagem e a auditoria, e deixe a decisão final com um humano.
Boas práticas de projetos de código aberto com LLM - O Mínimo
Instalação simples, testes e CI confiáveis e documentação sobre o problema. Releases padronizados deixam a automação previsível.
Clean Code pra Agentes de IA
Quando o principal leitor é um agente: código pequeno, nomes fáceis de achar com grep, proveniência, testes headless e regras explícitas.
Como me precaver pros meus agentes não apagarem minhas coisas?
Cinco meses em modo YOLO sem nenhum acidente, e ainda sem confiar: snapshots BTRFS, backups com restic, sandbox e disciplina.
Experimentos e ferramentas
Coisas que eu fiz ou testei, incluindo as que não deram certo.
Desafio pra IA: converter ROMs de NES pra Master System/SMS
Modelos de fronteira contra a tradução de 6502 pra Z80, com o emulador como oráculo de feedback, e onde os mappers travam tudo.
Usando IA pra resolver meus probleminhas do dia-a-dia
Um relógio de mesa com widgets, leitores de mangá, email, treino de digitação, karaokê: ferramentinhas nascidas de pequenos incômodos.
AI-MEMORY 2.0 - o melhor sistema de memória para agentes e times
O formato aberto OKF, embeddings locais por padrão e times trabalhando em paralelo, comparado com as alternativas.
Vibe Code: Do Zero à Produção em 6 DIAS | The M.Akita Chronicles
Como a newsletter, o blog, o podcast e o bot de Discord do The M.Akita Chronicles foram pro ar em seis dias e 201 commits.
Opiniões
Onde eu bato de frente com o hype. Espere palavras fortes.
Prefiro pedir desculpas do que pedir permissão.
Hot take: Harness, Loop Engineering, Graph Engineering são Bullshit
Trinta repositórios públicos, um benchmark e uma maratona de IA, e nenhum deles precisou de uma disciplina nova com preço de consultoria.
RANT: IA acabou com os programadores?
Por que a IA não vai substituir programadores experientes, o teto da curva S dos LLMs atuais e o que muda pra quem é engenheiro.
Tudo aqui é open source
As ferramentas, as skills e o benchmark são repositórios públicos. Faça um fork e monte a versão que encaixa no seu jeito de trabalhar.