주요 모델 전부, 같은 사보타주 앱으로 테스트
버전 4는 스프린트 일곱 번에 걸쳐 커지는 Rails 앱 하나이고, 그동안 격리된 서브에이전트가 실제 CVE를 바탕으로 사보타주 열네 개를 심습니다. 모델은 경계심으로 순위를 매깁니다. 망가진 것을 알아채고 고쳤는가? 여기까지 오려고 벤치마크를 세 번째로 처음부터 다시 만들었습니다.
주요 프런티어 모델이 나오면 같은 표로 돌립니다. 최근 라운드에서는 2026년 9월 23일에 모델 5개를 추가했습니다. 어떤 모델을 어디에 쓸지, 작업당 비용이 얼마인지 저는 이렇게 정합니다.
- 44
- 순위에 오른 모델
- 14
- 찾아내야 할 사보타주
- 7
- 실행당 스프린트
- $4,000+
- 9일 동안 쓴 비용
벤치마크
제 모델 선택 뒤에 있는 데이터, 그리고 예전 테스트가 포화됐을 때 방법이 어떻게 바뀌었는지.
LLM 벤치마크 v4: Opus 5.5, GPT 6 Sol과 Luna, MiMo 2.6, Grok 4.7
v4 표에 새 모델 다섯 개가 들어갑니다. 업그레이드할 가치가 있는지, 그리고 Grok 4.7이 왜 전작보다 뒤처지는지 다룹니다.
새 LLM 벤치마크 v4, 1부: 과정
버전 하나를 통째로 버린 이유, 사보타주를 심은 Rails 앱의 작동 방식, 그리고 비용 이야기입니다. 9일 동안 4,000달러가 넘게 들었습니다.
새 LLM 벤치마크 v4, 2부: 39개 모델 순위
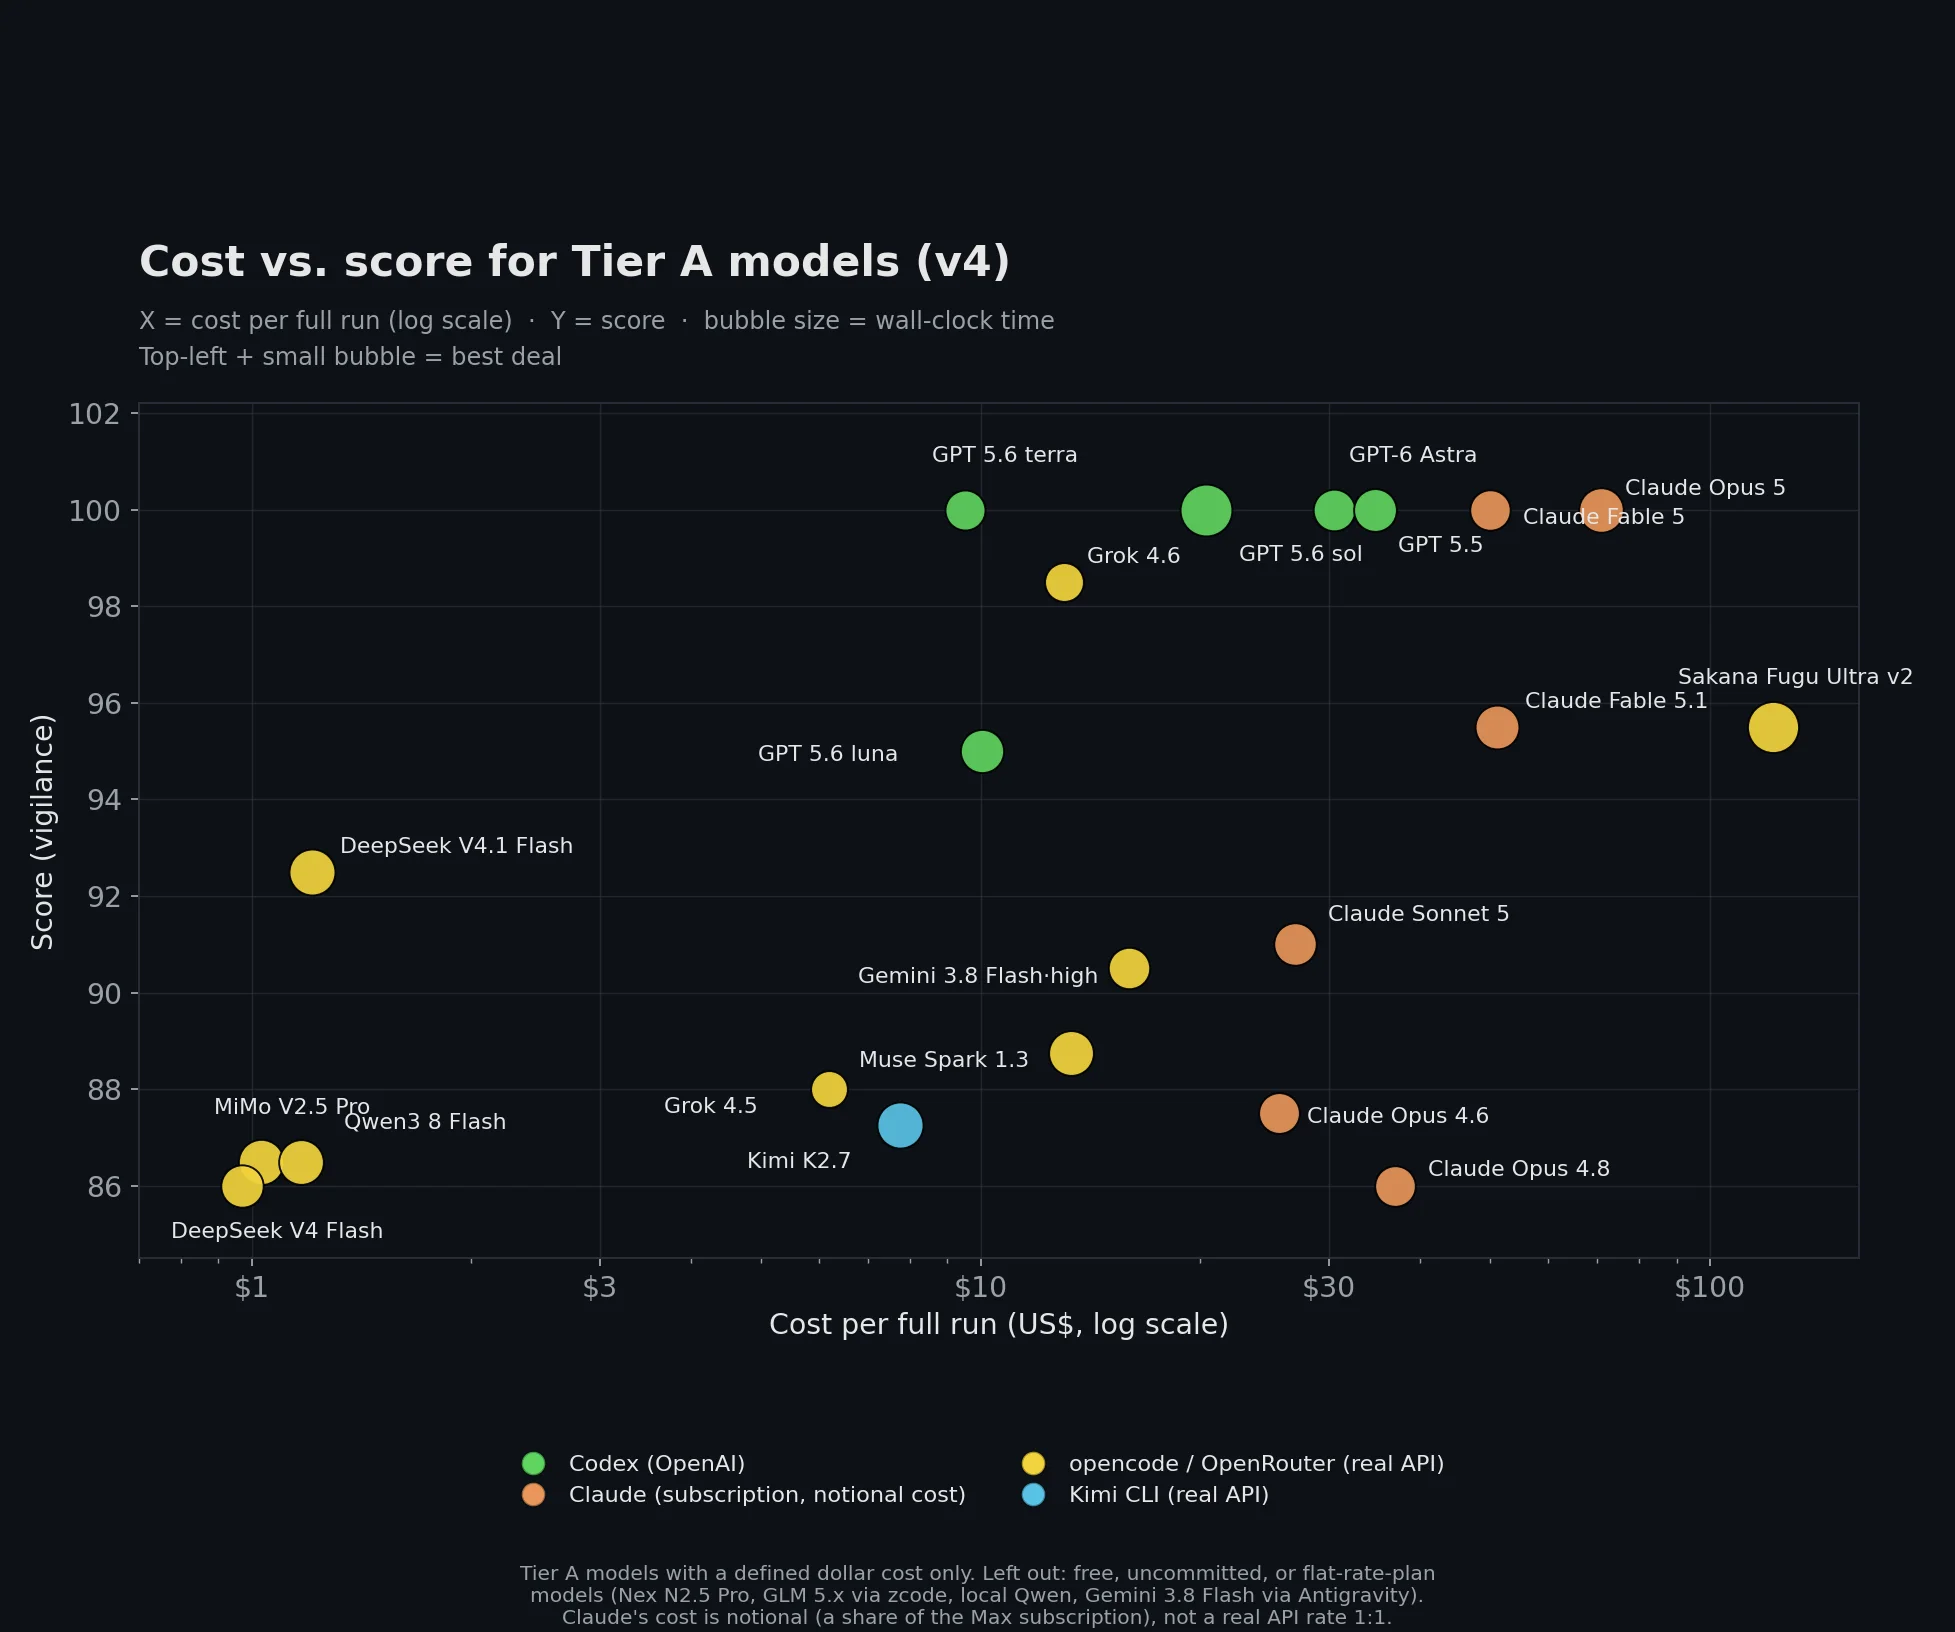
경계심 기준으로 정렬한 전체 표입니다. 최상위 동점이 여섯, Claude 절반을 이기는 무료 모델, 그리고 점수 대비 비용을 봅니다.
LLM 벤치마크: 한 프로젝트에 여러 모델을 섞을 가치가 있을까?
Claude Code, opencode, Codex에서 조합 일곱 가지를 돌려 봤고, 강한 모델 하나가 기본값으로 남은 이유를 설명합니다.
에이전트와 일하는 방식
한 사람이 이만큼의 프로젝트를 관리할 수 있게 해 주는 프로세스, 스킬, 안전망.
제 AI 스킬 이야기
스킬은 텍스트 파일에 담긴 프롬프트입니다. 제 스킬로 PR과 이슈를 천 개 넘게 처리했습니다. 읽어 보고, 자기 것을 직접 쓰세요.
핑계는 그만, 더 많이 배포하기
프런티어 모델이 대부분의 개발자보다 실수를 덜 하는 지금, 리뷰 관료주의는 배포를 붙잡는 마지막 핑계입니다. 2월부터의 제 숫자를 공개합니다.
오픈 소스 프로젝트에 대한 AI 기여: 제 생각
AI가 만든 풀 리퀘스트는 쓰레기까지 포함해서 계속 옵니다. 분류와 감사는 자동화하고 최종 결정은 사람이 내립니다.
LLM 시대의 오픈 소스 모범 사례: 최소한의 것
간단한 설치, 믿을 수 있는 테스트와 CI, 문제를 설명하는 문서. 표준적인 릴리스가 자동화를 예측 가능하게 만듭니다.
AI 에이전트를 위한 클린 코드
에이전트가 주 독자일 때 필요한 것들입니다. 작은 코드, grep하기 쉬운 이름, 출처 기록, 헤드리스 테스트, 명시적인 규칙.
에이전트가 내 파일을 지우지 못하게 막는 법
YOLO 모드로 다섯 달 동안 사고가 없었지만 여전히 믿지 않습니다. BTRFS 스냅숏, restic 백업, 샌드박스, 그리고 규율로 지킵니다.
실험과 도구
만들거나 시도해 본 것들입니다. 안 된 것도 포함해서.
AI 도전: NES ROM을 Master System으로 변환하기
프런티어 모델에게 6502에서 Z80으로의 번역을 맡기고 에뮬레이터를 피드백 오라클로 썼습니다. 매퍼에서 모든 것이 멈추는 지점도 봅니다.
AI로 소소한 일상 문제 해결하기
위젯이 달린 탁상시계, 만화 뷰어, 이메일, 타자 연습, 노래방. 작은 불편에서 태어난 작은 도구들입니다.
ai-memory 2.0
공개 포맷 OKF, 기본값이 된 로컬 임베딩, 팀 단위 병렬 작업을 다른 대안들과 비교합니다.
바이브 코딩: 6일 만에 0에서 프로덕션까지
The M.Akita Chronicles의 뉴스레터, 블로그, 팟캐스트, Discord 봇이 6일, 커밋 201개 만에 오픈한 과정입니다.
의견
과대광고에 반박하는 곳입니다. 말이 셀 수 있습니다.